OpenAI presenta a Model ML como caso de uso de GPT-5.6 Sol en finanzas: 100% de decks completados
OpenAI documenta el caso de Model ML, que integra GPT-5.6 Sol para generar PowerPoint y Excel editables en tareas financieras, con mejoras frente a Opus 5 y Fable 5 medidas en un benchmark propio.
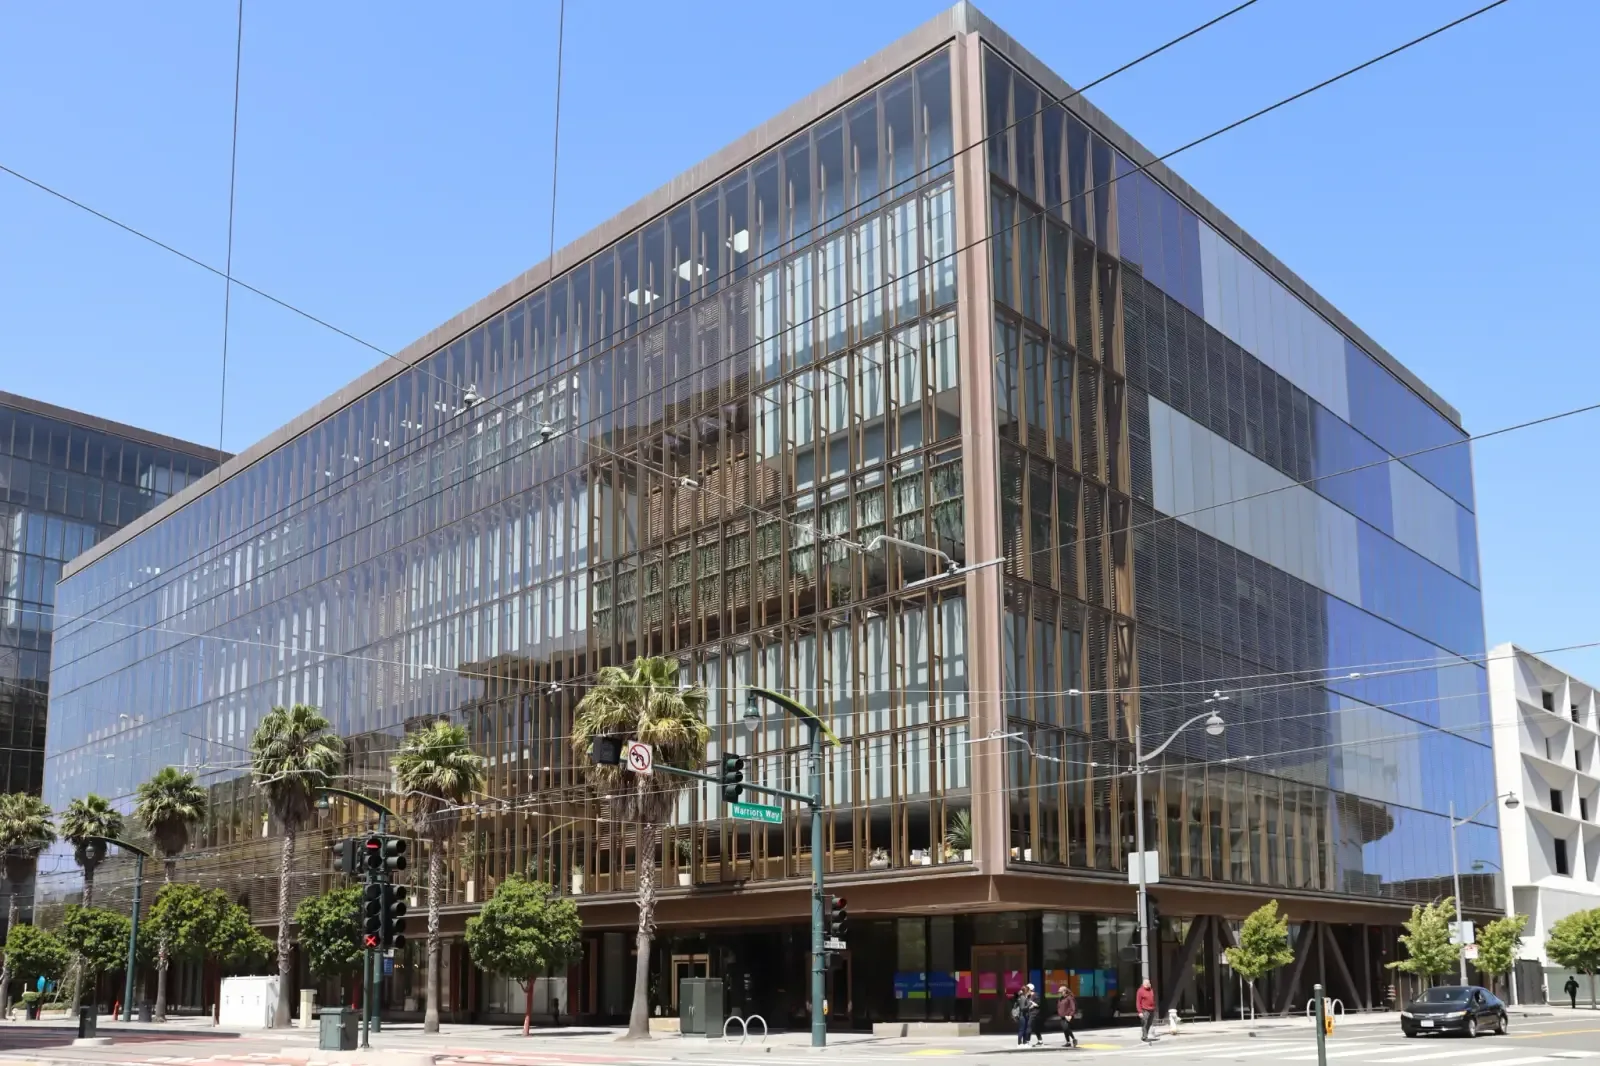
Edificio de oficinas de OpenAI en 1515 Third Street, Mission Bay, San FranciscoEl Forum · Fototeca de El Forum · OWN_WORK
Qué muestra el caso de estudio de OpenAI sobre Model ML
OpenAI ha publicado en su índice oficial un caso de estudio sobre Model ML, compañía que usa GPT-5.6 Sol dentro de flujos de trabajo financieros para generar archivos de PowerPoint y Excel que quedan editables al terminar, no solo como capturas o PDF estáticos.
Las cifras de rendimiento proceden de Composite, el benchmark propio de Model ML para evaluar IA en servicios financieros, combinado con pruebas internas de la compañía. Según esos datos, GPT-5.6 Sol completó el 100% de los decks de PowerPoint solicitados, frente al 76% de Opus 5, y redujo el consumo de tokens un 21% frente a Fable 5 en decks y un 36% frente a Opus 5 en workbooks de Excel.
OpenAI cita además un caso de uso de un gestor global de activos, sin identificar, que asegura haber reducido a unos 5 minutos la elaboración de una 'tearsheet' personalizada —un resumen de una página con los datos clave de una inversión o fondo— que antes le llevaba aproximadamente una hora.
Las cifras del anuncio, comparadasElaboración propia a partir de los datos del expediente%Ver los datos en tabla
Las cifras del anuncio, comparadas
Concepto
%
tasa de finalización de PowerPoint con GPT-5.6 Sol
100
menos tokens por workbook de Excel
36
menos tokens por deck de PowerPoint
21
readiness para revisión profesional
43,3
Fuente: OpenAI
Qué mide y qué no mide este benchmark
Todas las cifras de mejora frente a Opus 5 y Fable 5 —tokens, tasa de finalización, calidad de deck, adherencia al brief, jerarquía y consistencia— salen de un benchmark diseñado por la propia Model ML y de pruebas internas de OpenAI, no de una evaluación independiente. El dato de 'readiness para revisión profesional' (43,3% frente a 26,7%) sigue la misma lógica: es una métrica propietaria, no un estándar de la industria.
El material publicado no incluye importes económicos del acuerdo entre OpenAI y Model ML ni la fecha exacta de publicación del artículo. Tampoco se detalla el tamaño de la muestra de documentos usada en las pruebas ni qué versión concreta de Opus o Fable 5 sirvió de comparación.